Содержание
Root cause analysis (RCA, анализ первопричин) это разбор сбоя, который отвечает на вопрос, почему поломка вообще стала возможной. Починить сломанное мало: нужно убрать условие, из-за которого сбой случился, тогда он не повторится. Латание возвращает сайт в строй до следующего раза, устранённая первопричина закрывает целый класс проблем. Для начала хватит метода «5 почему» и отчёта на одну страницу.
Что такое root cause analysis простыми словами
Сайт упал. Разработчик заходит на сервер, видит, что закончилось место на диске, удаляет старые файлы, сайт поднимается. Инцидент закрыт? Формально да. Но через полгода место закончится снова, и всё повторится, может быть, в «чёрную пятницу».
Root cause analysis задаёт другой вопрос: почему место закончилось и почему об этом никто не узнал заранее. Ответ ведёт к мерам, которые убирают сам класс проблем: автоматическая очистка, мониторинг диска, алерт при заполнении.
В индустрии для этого есть устоявшаяся практика postmortem, разбор после инцидента. Её подробно описали инженеры Google в книге Site Reliability Engineering: документ фиксирует, что произошло, какое было влияние, что сделали, какие первопричины и какие меры приняты, чтобы не повторилось.
Почему латание обходится дороже
| Латание | Устранение первопричины | |
|---|---|---|
| Что делаем | Убираем симптом | Убираем условие, при котором сбой возможен |
| Время на инцидент | Меньше сейчас | Больше сейчас, ноль потом |
| Повторы | Возвращаются, часто в худший момент | Класс сбоев закрыт |
| Знания | Остаются в голове у того, кто чинил | Записаны в отчёте |
| Для бизнеса | Каждый месяц новый пожар | Сбоев становится меньше с каждым разбором |
Если одна и та же проблема возвращается, а в отчётах подрядчика каждый раз написано «исправлено», это верный признак латания. Повторяющиеся сбои это ещё и форма технического долга, подробнее в статье «Технический долг: когда он начинает стоить денег».
Метод «5 почему» на примере
Метод придумал Тайити Оно в Toyota, и он хорошо работает для IT. Задаём вопрос «почему?» к каждому ответу, пока не дойдём до причины, которую можно исправить навсегда. Число пять условное: иногда хватает трёх вопросов, иногда нужно семь.
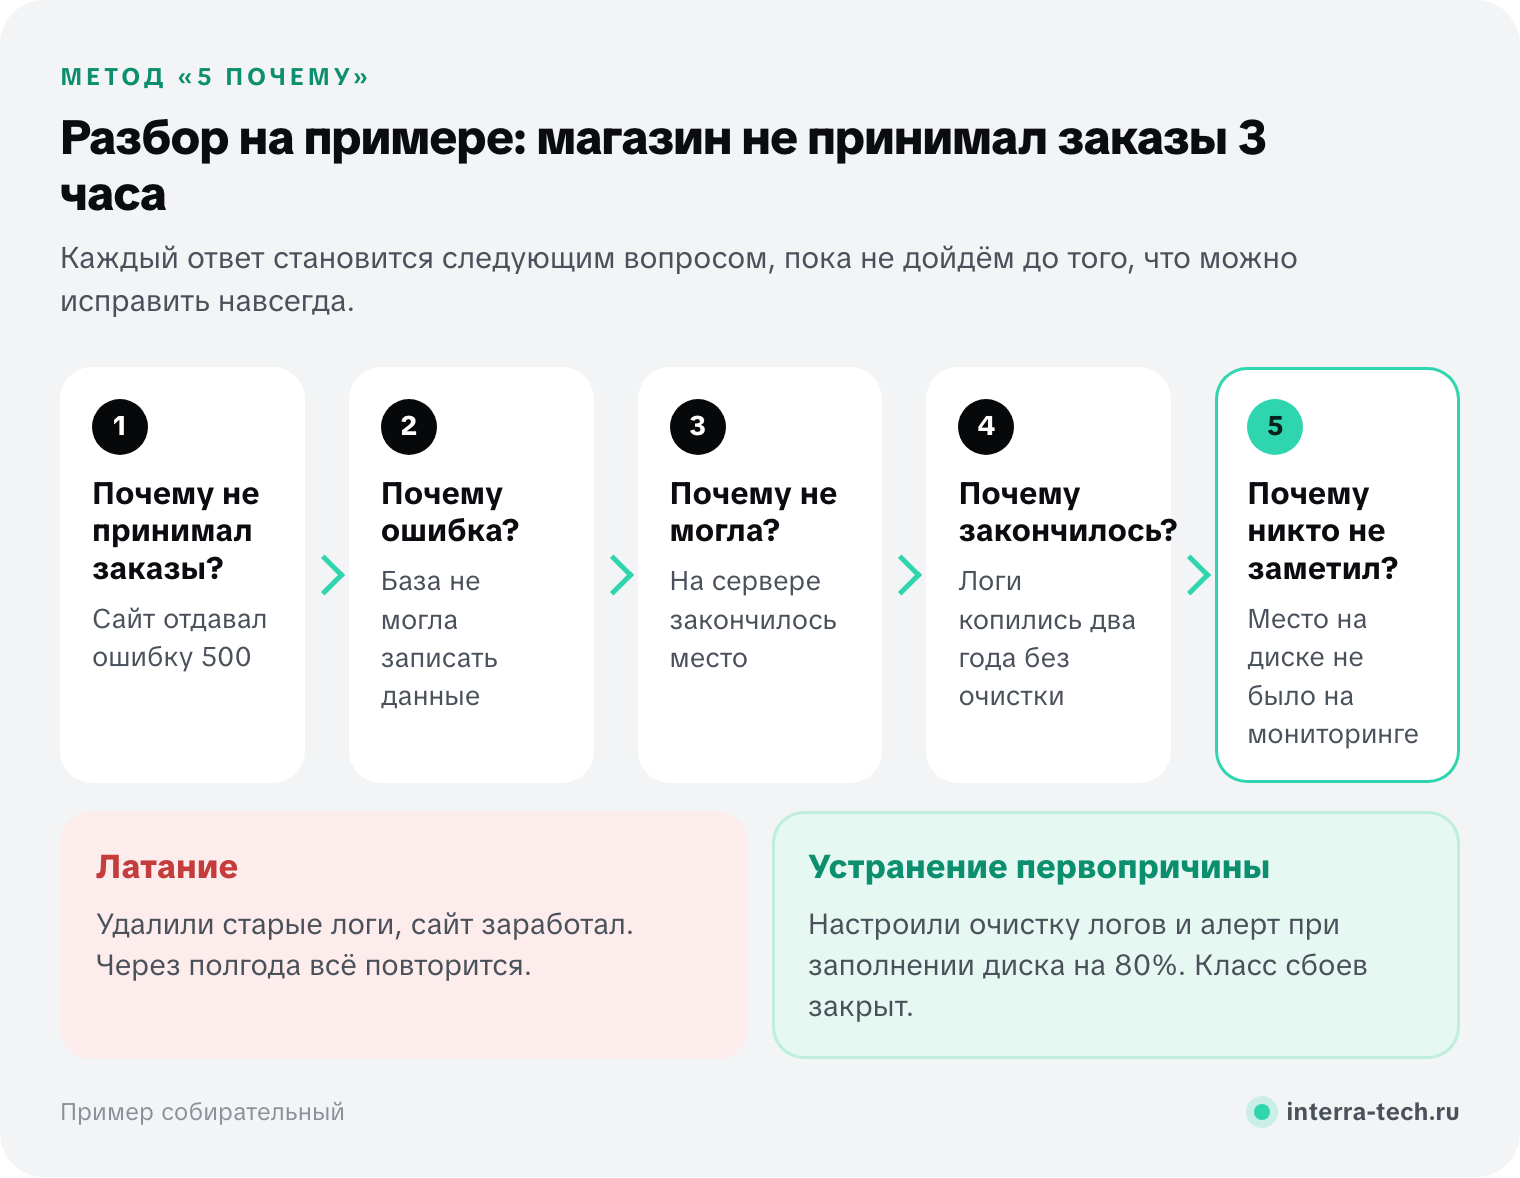
У этого сбоя две первопричины, и обе важны. Логи не очищались, и диск не был на мониторинге. Если исправить только первое, следующий сбой по похожей причине (например, разросшиеся бэкапы) снова застанет врасплох.
Диаграмма Исикавы: когда причин много
Для сложных сбоев, где сошлось несколько факторов, удобна диаграмма Исикавы («рыбья кость»). Возможные причины раскладывают по группам и проверяют каждую:
- Код: последние изменения, ошибки в логике, необработанные исключения.
- Инфраструктура: серверы, диски, сеть, сертификаты, DNS.
- Данные: объём, некорректные записи, блокировки в базе.
- Внешние сервисы: платёжный шлюз, 1С, службы доставки, почта.
- Процессы: как выкладывали изменения, кто и что проверял, был ли мониторинг.
- Нагрузка: пик трафика, рассылка, рекламная кампания.
Обычно реальная картина такая: изменение в коде плюс рост нагрузки плюс отсутствие мониторинга. Каждая из трёх причин по отдельности сбоя бы не вызвала.
Как провести разбор инцидента
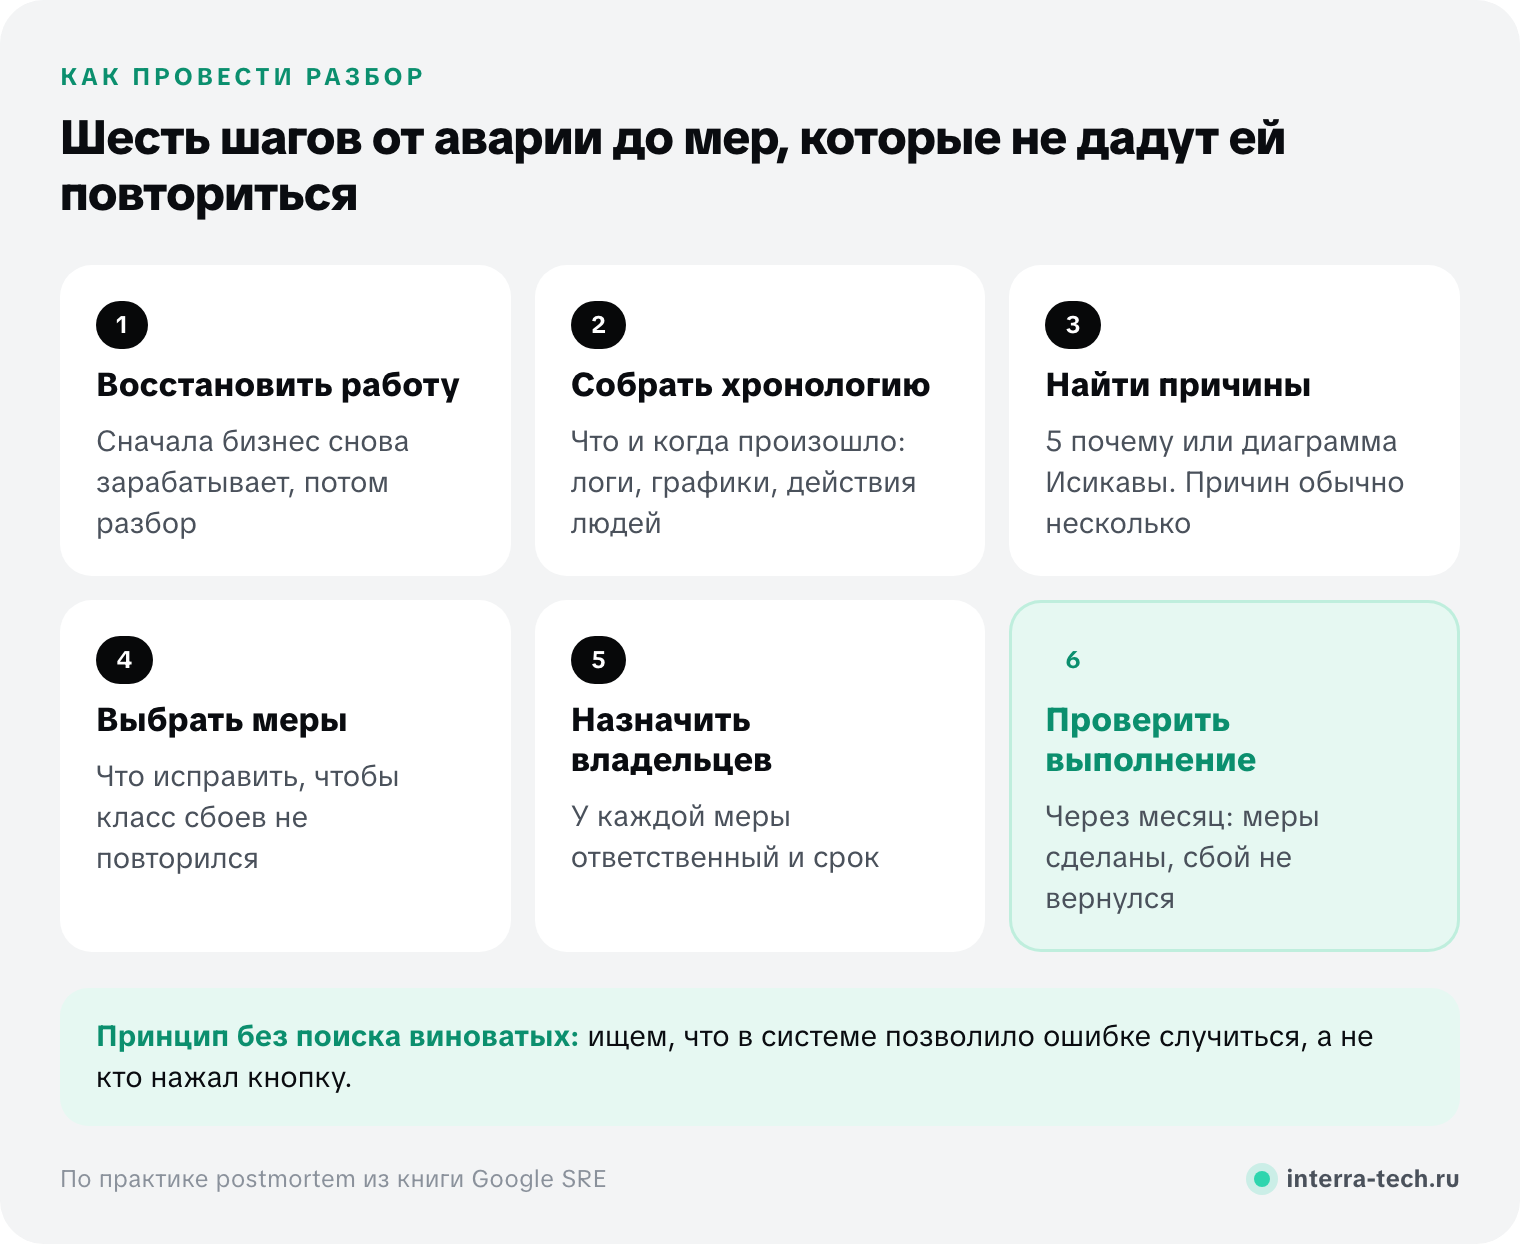
Главный принцип, который описывают инженеры Google: разбор без поиска виноватых. Когда за ошибку наказывают, люди начинают их скрывать, а скрытые ошибки повторяются. Поэтому на разборе спрашивают, что в системе позволило этому случиться. Вопрос «кто виноват» не задают.
Шаблон отчёта о разборе инцидента
Отчёт не должен быть длинным. Хватает одной-двух страниц с такими разделами:
- Что произошло. Одним абзацем, понятным руководителю.
- Влияние. Сколько длился сбой, что не работало, сколько заказов, заявок или денег затронуто.
- Хронология. Когда начался сбой, когда его заметили, кто и что делал, когда восстановили работу.
- Первопричины. Цепочка «почему» и все найденные причины.
- Что сработало и что нет. Например, мониторинг заметил сбой через 2 минуты, но откат занял час.
- Меры. Список действий с владельцем и сроком для каждого.
- Проверка. Дата, когда проверим, что меры выполнены.
Типичные ошибки при RCA
- Разбор вместо восстановления. Пока сайт лежит, нужно поднимать его, а не искать причину. Логи и данные сохраняют для разбора потом.
- Остановка на первой причине. «Закончилось место на диске» пока только симптом.
- Поиск виноватого. Убивает честность, и следующие ошибки скрывают.
- Меры без владельца и срока. Через месяц их никто не помнит.
- Разбор только больших аварий. Мелкие повторяющиеся сбои часто стоят дороже одной большой аварии.
Разбор первопричин в поддержке ИнТерраТех
На нашей поддержке каждый серьёзный инцидент заканчивается разбором: отчёт объясняет первопричину и принятые меры, а повторяющийся сбой уходит в план работ, а не чинится по кругу. Сроки реакции записаны в договоре: критичный инцидент берём в работу в течение 2 часов.
Если сбои у вас повторяются, а причину никто найти не может, начать стоит с аудита: он показывает слабые места системы до того, как они превратятся в аварии.
Частые вопросы
Что такое root cause analysis?
Это анализ первопричин: разбор сбоя, который ищет не то, что сломалось, а условие, при котором поломка стала возможной. Цель в том, чтобы сбои этого класса больше не повторялись.
Как переводится root cause analysis?
Дословно «анализ корневой причины». В русском языке говорят «анализ первопричин» или просто RCA.
Чем RCA отличается от postmortem?
Postmortem это весь документ о разборе инцидента: что случилось, влияние, хронология, меры. Root cause analysis это его центральная часть, поиск первопричин.
Нужно ли разбирать каждый сбой?
Подробно разбирают критичные инциденты и любые повторяющиеся сбои. Для мелких единичных проблем достаточно короткой записи. Если мелкая проблема вернулась второй раз, её разбирают как серьёзную.
Сколько времени занимает разбор инцидента?
Обычно от нескольких часов до пары дней после восстановления работы. Сам разбор недолгий, больше времени уходит на выполнение мер, поэтому у каждой меры должен быть срок.